Canvas Engineering
Macroestructura causal declarada para dinámicas latentes de difusión inversa
Por Jacob Valdez
¿Y si pudieras proyectar la estructura causal de cualquier dominio sobre la propia geometría neuronal? Los modelos del mundo actuales quitan ruido a una bolsa plana de tokens: todo puede atender a todo, y la estructura que el modelo acabe usando la descubre por su cuenta, enterrada en pesos que no puedes leer. Canvas engineering es la apuesta contraria: es ingeniería de prompts para la dinámica del espacio latente en difusión inversa. Tú declaras la estructura de antemano y un compilador la hace exacta.
Distribuyes regiones con nombre sobre el canvas de difusión y declaras qué regiones pueden siquiera influir en cuáles otras, con qué frecuencia se actualiza cada una y qué papel juega cada una en la pérdida. Un compilador baja todo eso a máscaras de atención, pesos de pérdida y correspondencias de fotogramas sobre un transformer de difusión preentrenado de serie. El resultado: en lugar de una difusión inversa uniforme sobre una bolsa plana de tokens, la conectividad que declaraste hace que solo bloques concretos puedan afectarse entre sí. Esa restricción dura induce un grafo causal explícito y legible por humanos dentro de la dinámica de difusión inversa.
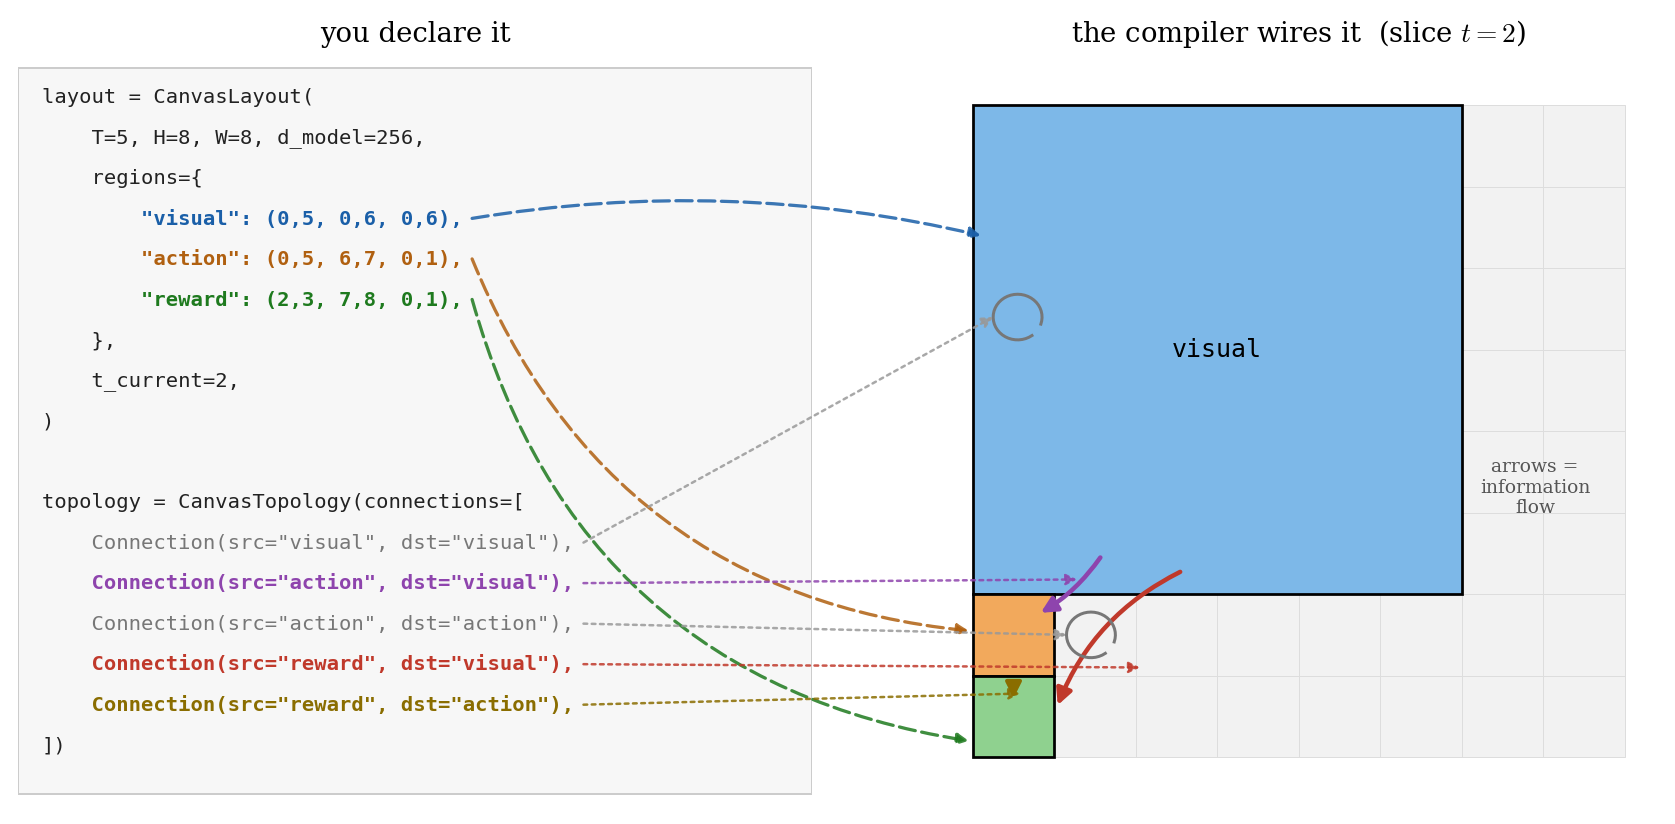
Connection declarada se convierte en una arista de atención autorizada: una flecha de flujo de información que puedes señalar.El reparto: tú fijas el cableado, los gradientes aprenden los pesos
La división del trabajo es precisa. Tú fijas si una arista existe, su dirección y su extensión temporal. Los gradientes — guiados por los datos o por pérdidas intrínsecas — determinan qué fluye por cada arista y todo lo que ocurre dentro de una región. Lo simbólico es lo macro; lo neuronal se queda en lo micro.
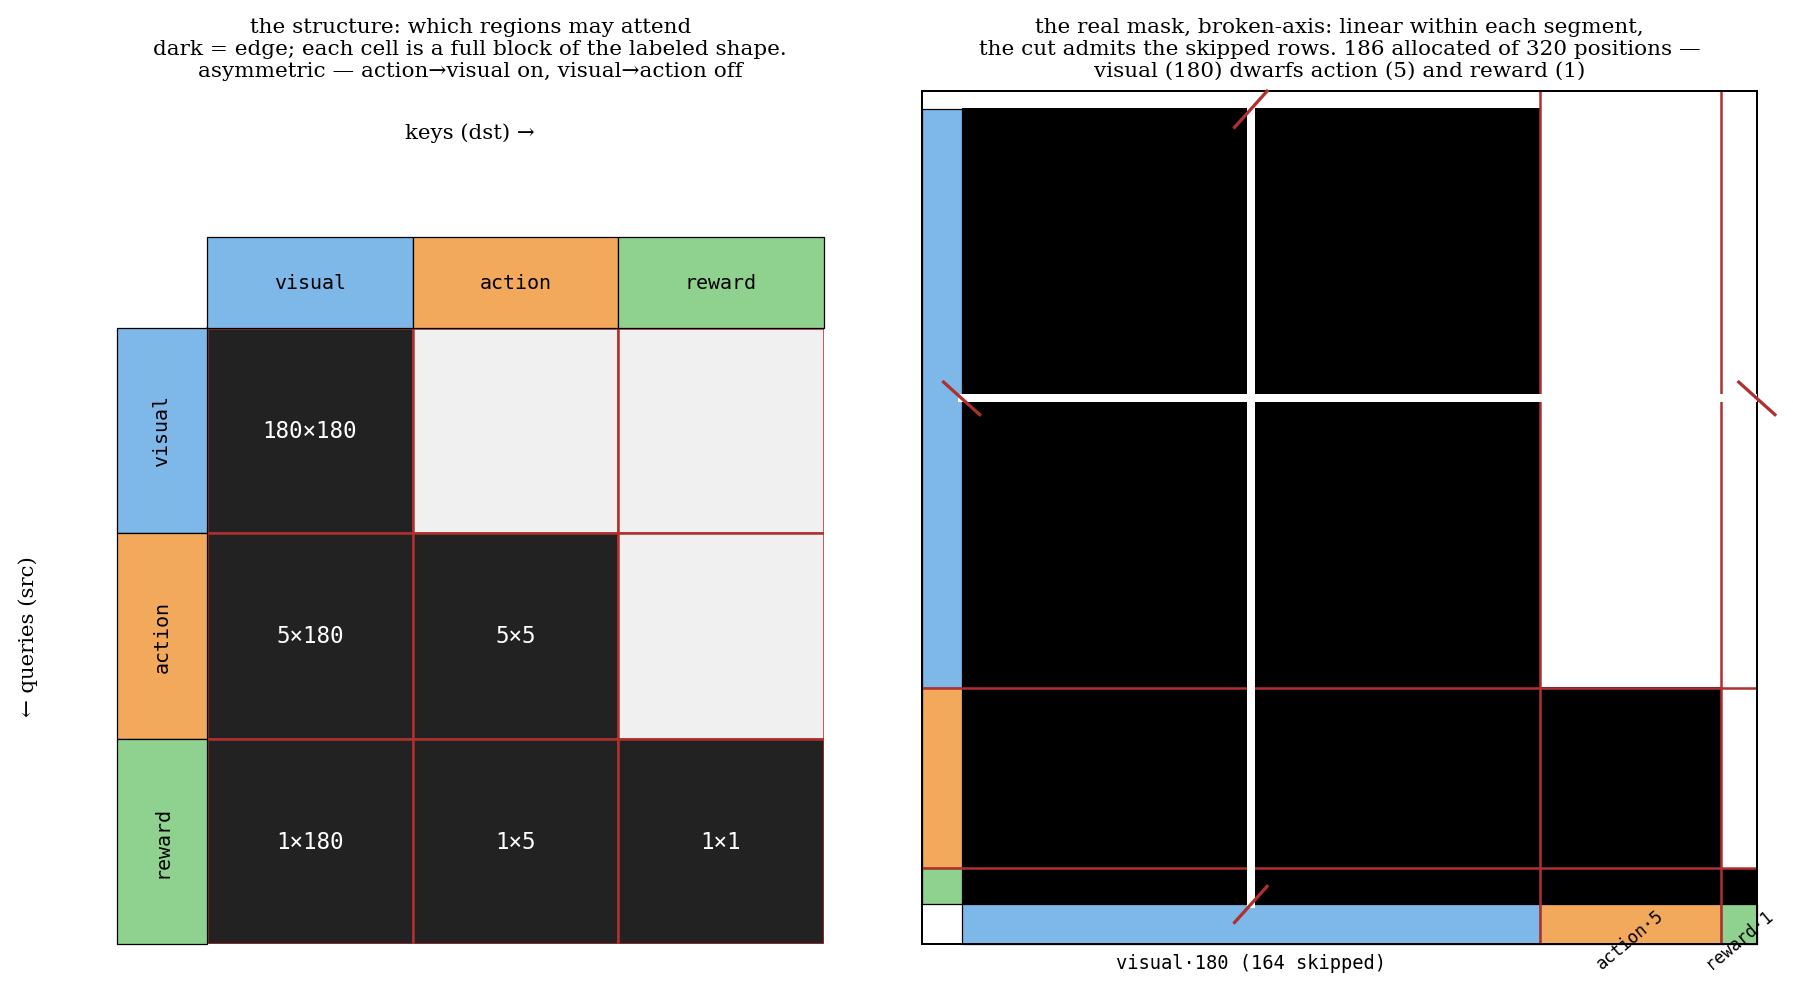
Y no hay interfaz entre las dos capas, porque la capa simbólica literalmente es la máscara de atención. Si no hay camino entre dos regiones, su independencia es exacta por construcción: una prohibición dura, no una penalización de regularización que el modelo pueda aprender a violar. Las aristas ausentes producen independencia marginal exacta; puedes demostrar que una región no puede influir en otra con solo leer el grafo.
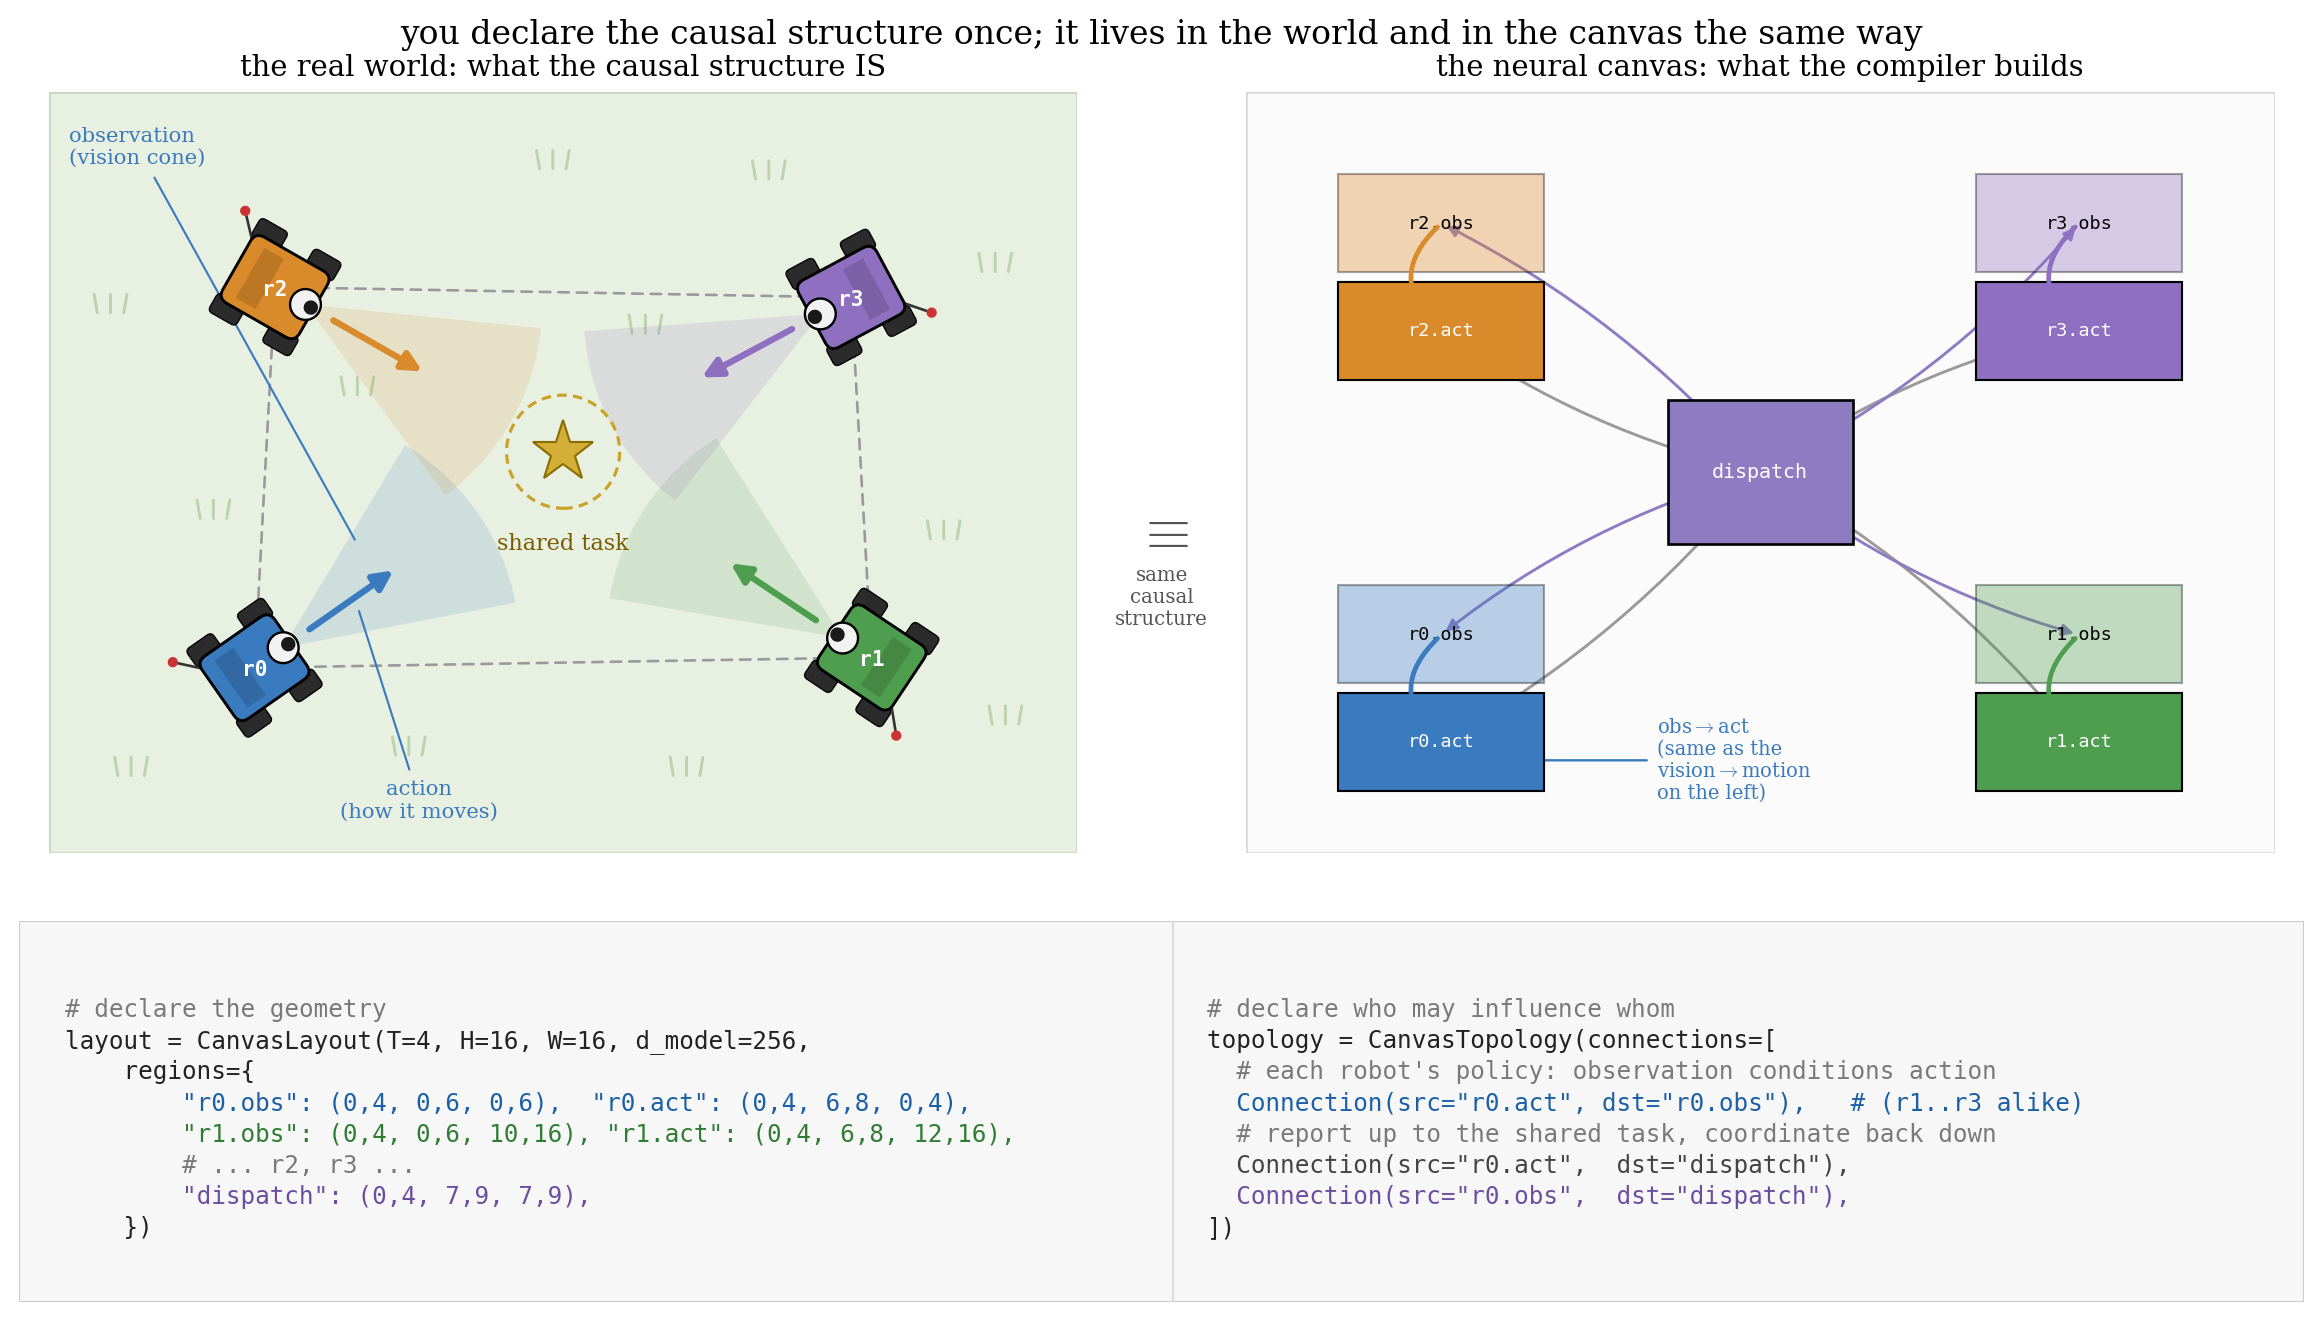
Vistas así, arquitecturas conocidas caen como casos particulares. Una política de difusión markoviana estándar no es más que un canvas de dos nodos: (observación) → acción, y (observación + acción) → siguiente observación. La coordinación multiagente tiene más piezas, pero no es menos limpia: cada agente se autoatiende sobre sus propias observaciones y acciones, y los agentes se coordinan solo a través de las aristas cruzadas que declares. La topología es el protocolo de coordinación, escrito como datos.
Decláralo en código: los esquemas compilan a canvas
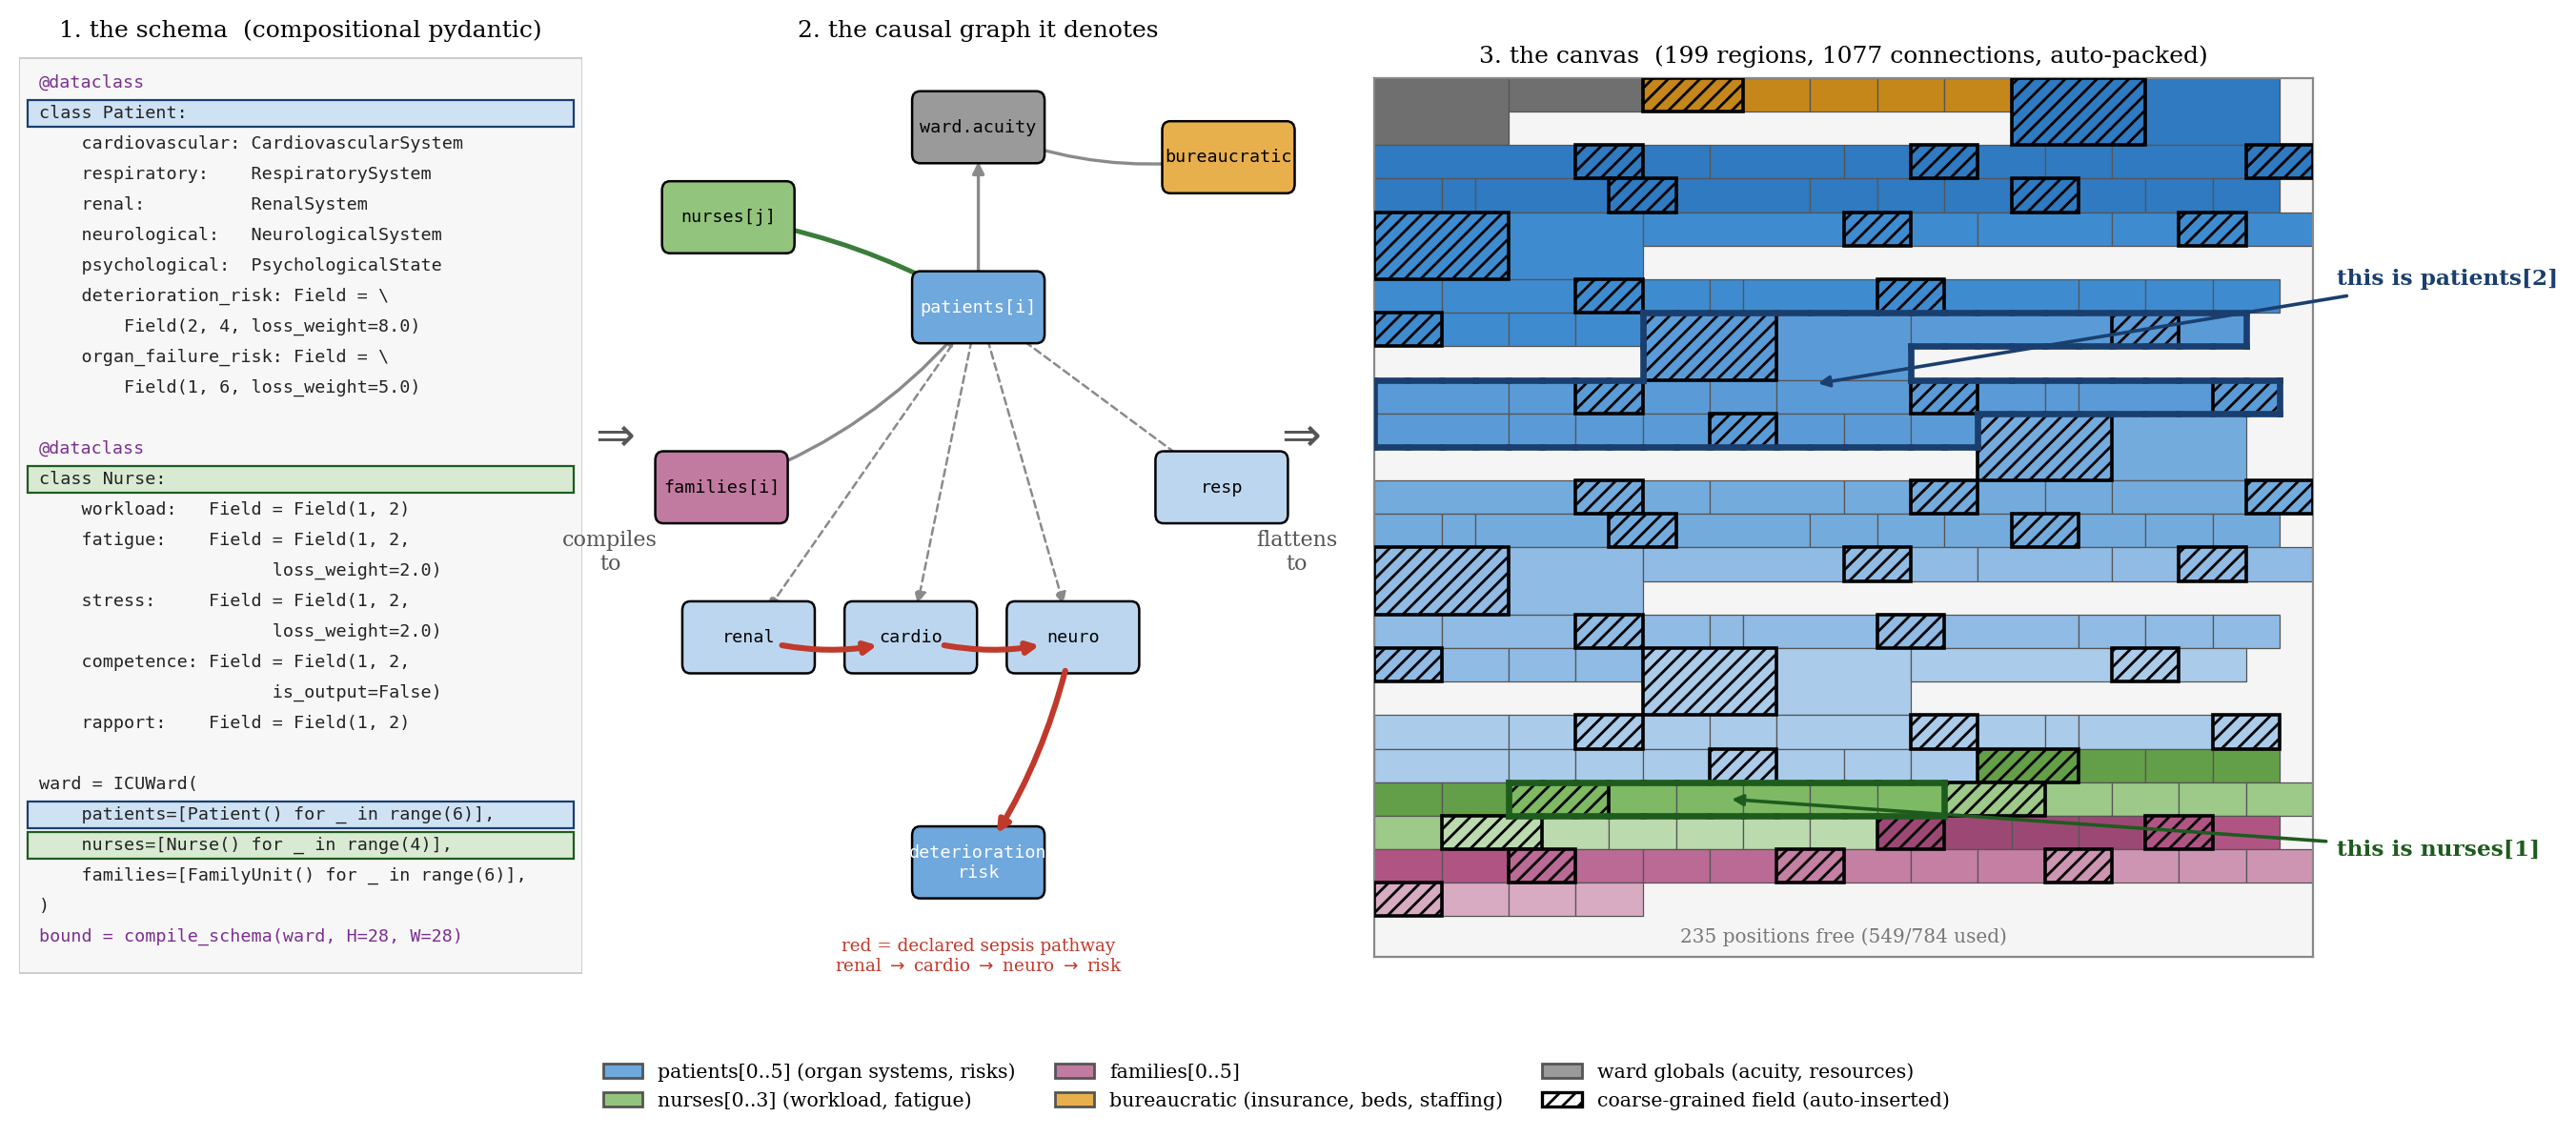
Repartir territorio latente a mano no escala. Por eso hay una capa superior: la biblioteca de canvas engineering es un compilador de declaraciones de esquema tipadas. Escribes la estructura causal como un objeto Python normal — dataclasses tipadas y anidadas con campos, pesos de pérdida y relojes de actualización — y compile_schema() la aplana en regiones y máscaras de atención por ti. Las relaciones complejas quedan declaradas de forma explícita y transparente, en código que puedes revisar.
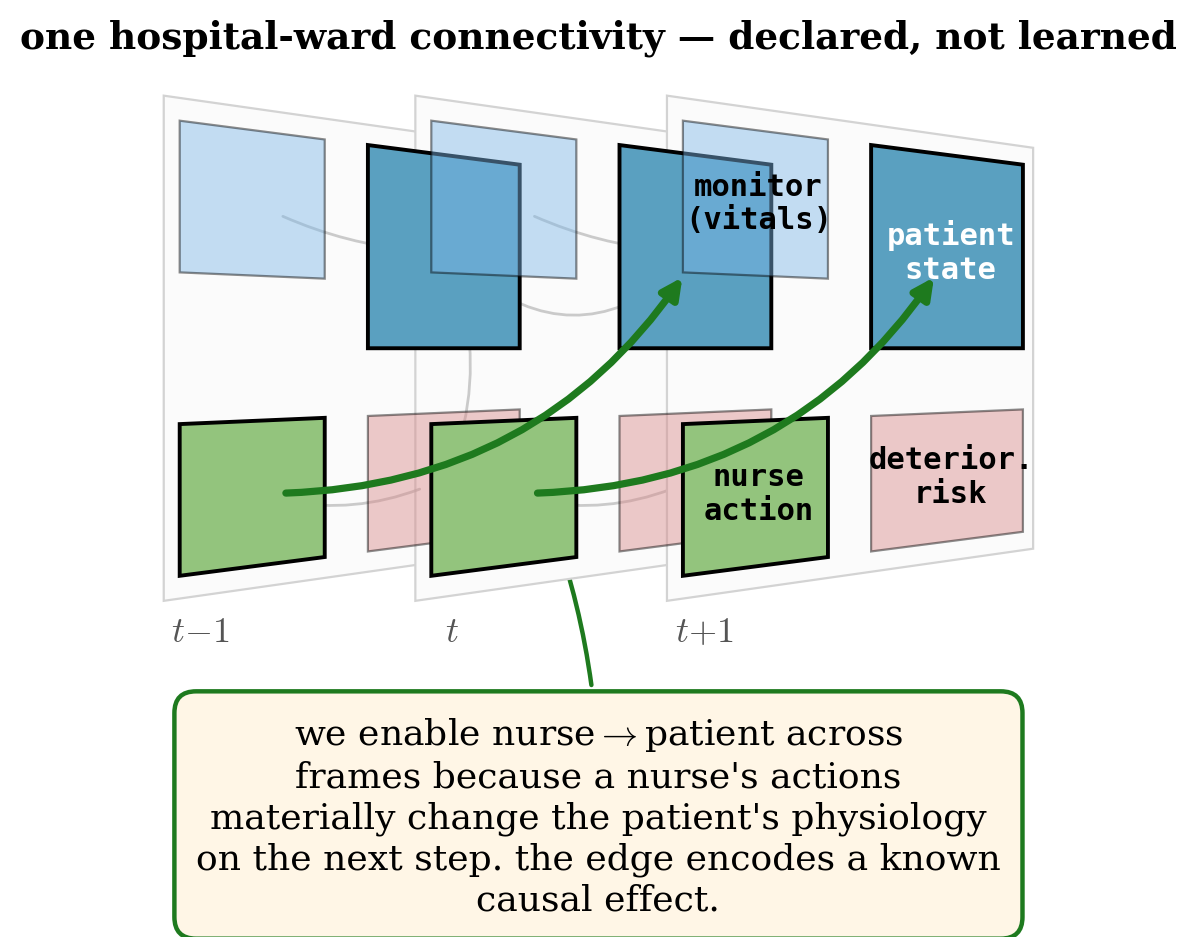
Para forzarlo, describimos la estructura a gran escala de una unidad de cuidados intensivos: seis pacientes con fisiología a nivel de órganos, cuatro enfermeras con dinámica de fatiga, presión aseguradora y de plantilla, y unidades familiares. Una sola llamada a compile_schema() asignó y empaquetó 199 regiones y 1077 conexiones sobre el canvas: heart_rate actualizándose cada fotograma, creatinine cada 24, cada una con su propio reloj declarado.
Y algo decisivo: cada región y cada arista es una decisión que puedes releer. Abajo hay tres vistas de una misma conectividad declarada de la unidad, cada una resaltando un enlace distinto — la acción de una enfermera que cambia a un paciente entre fotogramas, un estado que alimenta el riesgo, un estado que persiste en el tiempo — y cada una anotada con la razón causal por la que existe. No estás condenado a sondear e ingeniería inversa de lo que un modelo haya aprendido por su cuenta: el grafo lo escribiste tú.
El tensor latente es direccionable
Esa legibilidad apunta a una propiedad más profunda. El esquema del canvas es paralelo a la semántica de un struct en C: los límites de región son desplazamientos de struct, la topología es una convención de llamada y un esquema serializado es una ABI. El tensor latente pasa a ser direccionable: puedes nombrar exactamente qué posiciones son nurses[1] y leerlas. Es mapeo de memoria para compiladores, pero sobre el canvas latente de difusión.
Dos modelos que comparten un esquema pueden, por tanto, intercambiar estado latente directamente: sin tokenización, sin recodificación. Eso es un bostezo cuando la difusión es simplemente torch sobre una GPU, pero se pone serio en cuanto tienes que reaprovechar silicio optimizado para generar vídeos de gatos y ponerlo a hacer trabajo real: una ABI compartida es cómo mueves estado latente entre chips sin un viaje de ida y vuelta de decodificación y recodificación por medio.
Qué dicen realmente las mediciones
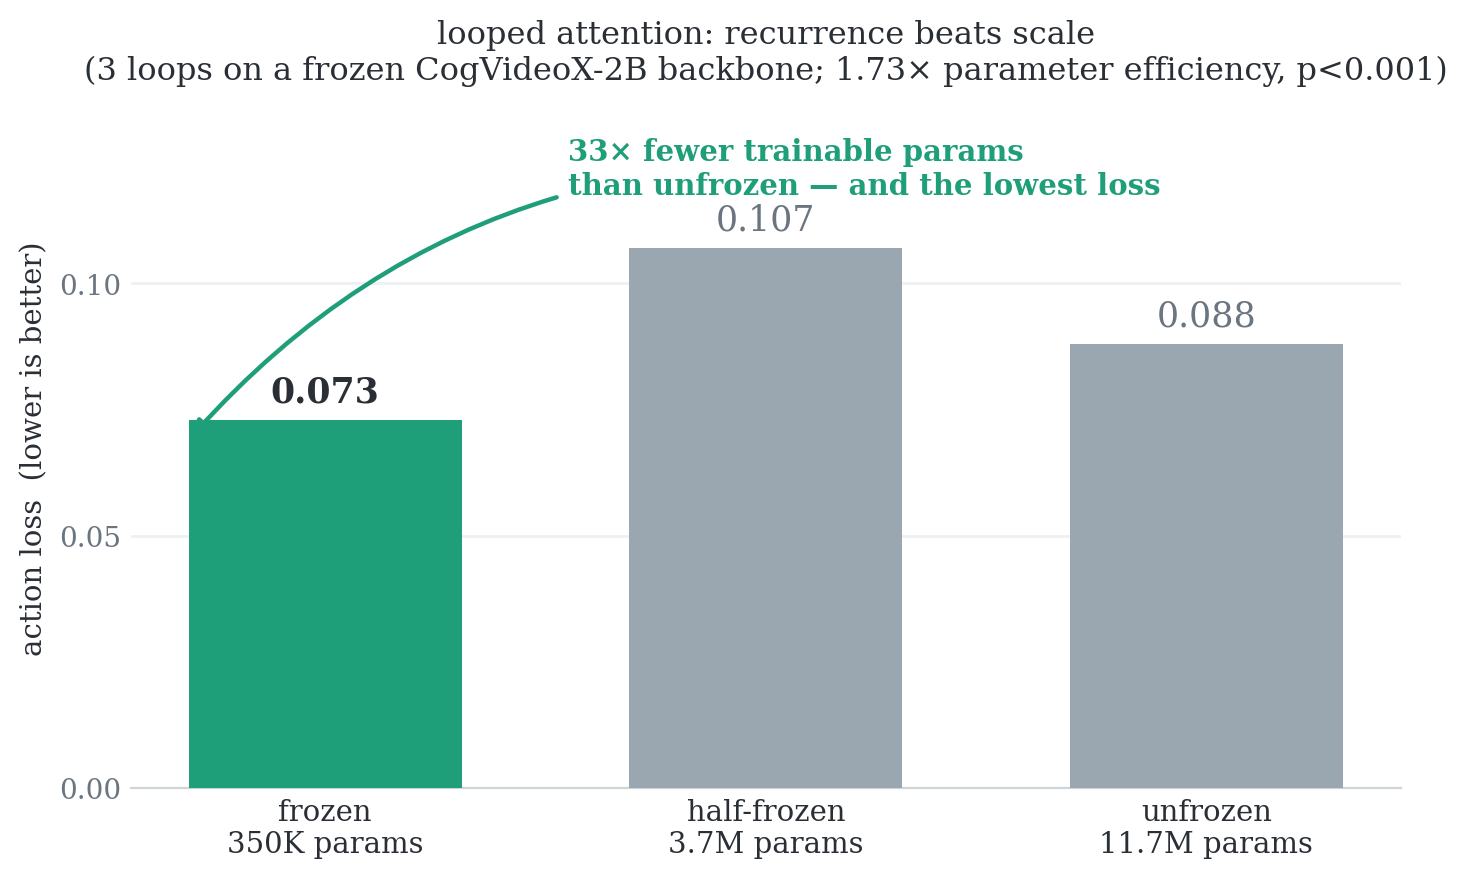
El registro empírico es deliberadamente honesto. A lo largo de 26 experimentos y 236 entrenamientos sobre CogVideoX-2B con BridgeData V2, el titular es un estudio de atención en bucle: iterar bloques congelados del transformer de difusión con embeddings de iteración aprendidos. Una configuración congelada de 3 bucles con solo 350 K parámetros entrenables superó a todas las condiciones sin congelar con 11,7 M — una eficiencia de parámetros de 1,73× con p < 0,001, y representaciones de bucle que convergen a puntos fijos.
Tres calibraciones mantienen la historia honesta:
- A esta escala, el beneficio del bucle es la regularización por compartir pesos, no un razonamiento iterativo detectable. Lo decimos.
- La estructura tiene que estar declarada: la mera coexistencia plana de modalidades degradó la predicción conjunta un 19 % (p < 0,0001). Meter tokens en el mismo tensor no es estructura; la topología sí.
- El diseño del canvas perdona: la pérdida fue casi insensible a cómo se repartieran exactamente los tokens (α = 0,011). Lo que hay que acertar es el grafo, no el presupuesto de píxeles.
Dos notas de alcance que mantenemos: los diseños de la UCI y del control aéreo son demostraciones arquitectónicas, no sistemas clínicos u operativos validados; y el modelo cortical predice las salidas de un codificador cerebral, no actividad neuronal medida directamente.
Qué queda abierto
La pieza clave es la estabilidad de la representación: el intercambio latente mediado por esquema, la calibración de la distancia de transferencia y las modalidades enchufables dan por hecho que una misma estructura declarada induce una geometría alineada de forma predecible entre semillas y backbones. Plausible, y sin demostrar. Más allá: una ablación decisiva de topología declarada frente a plana sobre el binding; si la estructura declarada sigue rindiendo a medida que datos y parámetros escalan más allá de 2 B; y la topología aprendida — proponer y podar aristas bajo un prior de dispersión, con el esquema declarado como prior y no como última palabra.
Pruébalo
Canvas engineering disuelve la frontera neuronal/simbólica convirtiendo el artefacto simbólico en un esquema — un sistema de tipos para el cómputo latente — cuya ejecución es atención enmascarada dentro de un transformer de difusión de serie. El artículo trae la derivación completa, los diseños trabajados (manipulación, flotas, control aéreo, la UCI, la corteza) y el archivo experimental íntegro.
La biblioteca
Un compilador Apache-2.0 que baja un esquema tipado de regiones, conectividad y relojes de actualización a máscaras de atención sobre un transformer de difusión preentrenado de serie. Incluye ejemplos ejecutables de cartpole, flotas de vehículos, el modelo hospitalario y conectividad cerebral.
pip install canvas-engineeringfrom canvas_engineering import compile_schema, CanvasModel
# Declare the causal macrostructure; the compiler lays it out.
canvas = compile_schema(MySchema) # regions + attention mask
model = CanvasModel.from_pretrained("cogvideox-2b", canvas=canvas)
model.fit(dataset) # gradients learn the weights
state = model.rollout(obs) # you fixed the wiring