Canvas Engineering
为逆向扩散潜空间动力学声明的因果宏观结构
作者:Jacob Valdez
如果你能把任意问题域的因果结构直接映射到神经几何本身,会怎样?当今的世界模型是在对一袋扁平的 token 去噪:一切都可以注意到一切,模型最终用上的结构由它自己摸索出来,埋在你读不懂的权重里。Canvas Engineering 押的是相反的一注——它是面向逆向扩散潜空间动力学的提示工程。结构由你预先声明,再由编译器把它变成精确的事实。
你在扩散画布上铺开一个个具名区域,声明哪些区域才被允许影响哪些区域、每个区域多久更新一次、以及各自在损失中扮演什么角色。编译器把这一切下译为一个现成预训练扩散 Transformer 上的注意力掩码、损失权重与帧映射。结果是:逆向扩散不再均匀地作用于一袋扁平 token,而是由你声明的连通性决定只有特定块之间才能相互影响。这条硬约束在逆向扩散动力学内部诱导出一张显式的、人可阅读的因果图。
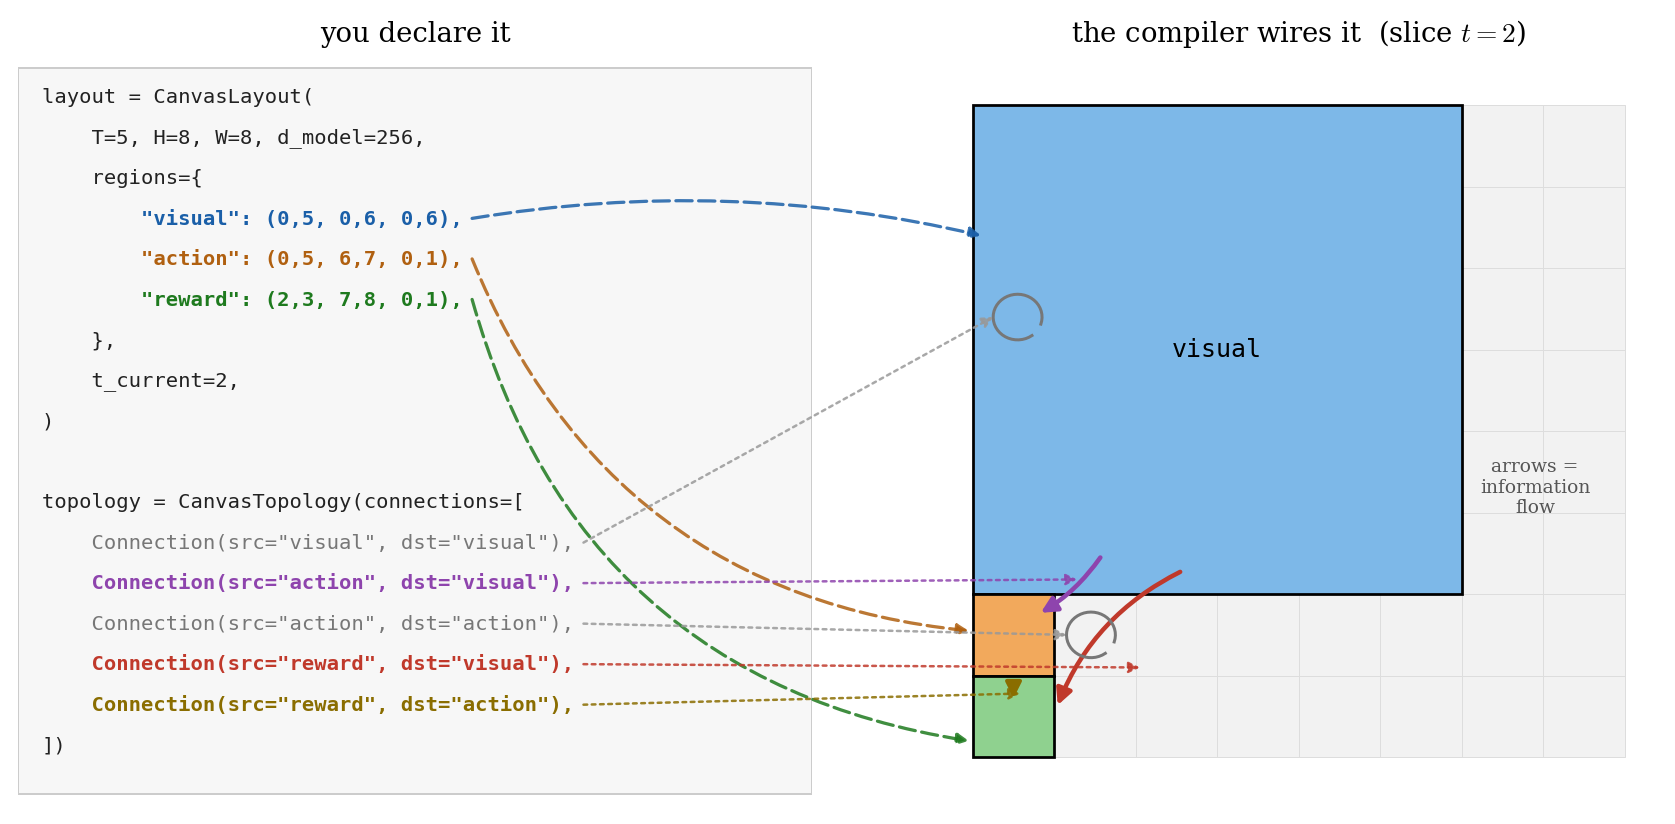
Connection 都成为一条获准的注意力边——一支你可以指着看的信息流箭头。分工:接线由你固定,权重由梯度学习
分工非常明确。你固定一条边是否存在、它的方向,以及它的时间跨度。梯度——由数据或内在损失驱动——决定沿每条边流动的是什么,以及区域内部发生的一切。符号层管宏观,神经层管微观。
而且两层之间没有接口,因为符号层本身就是注意力掩码。如果两个区域之间没有通路,它们的独立性就是构造上精确成立的——这是一条硬禁令,而不是模型可能学会绕过的正则化惩罚。缺失的边给出精确的边缘独立性;你只要读图,就能证明一个区域无法影响另一个。
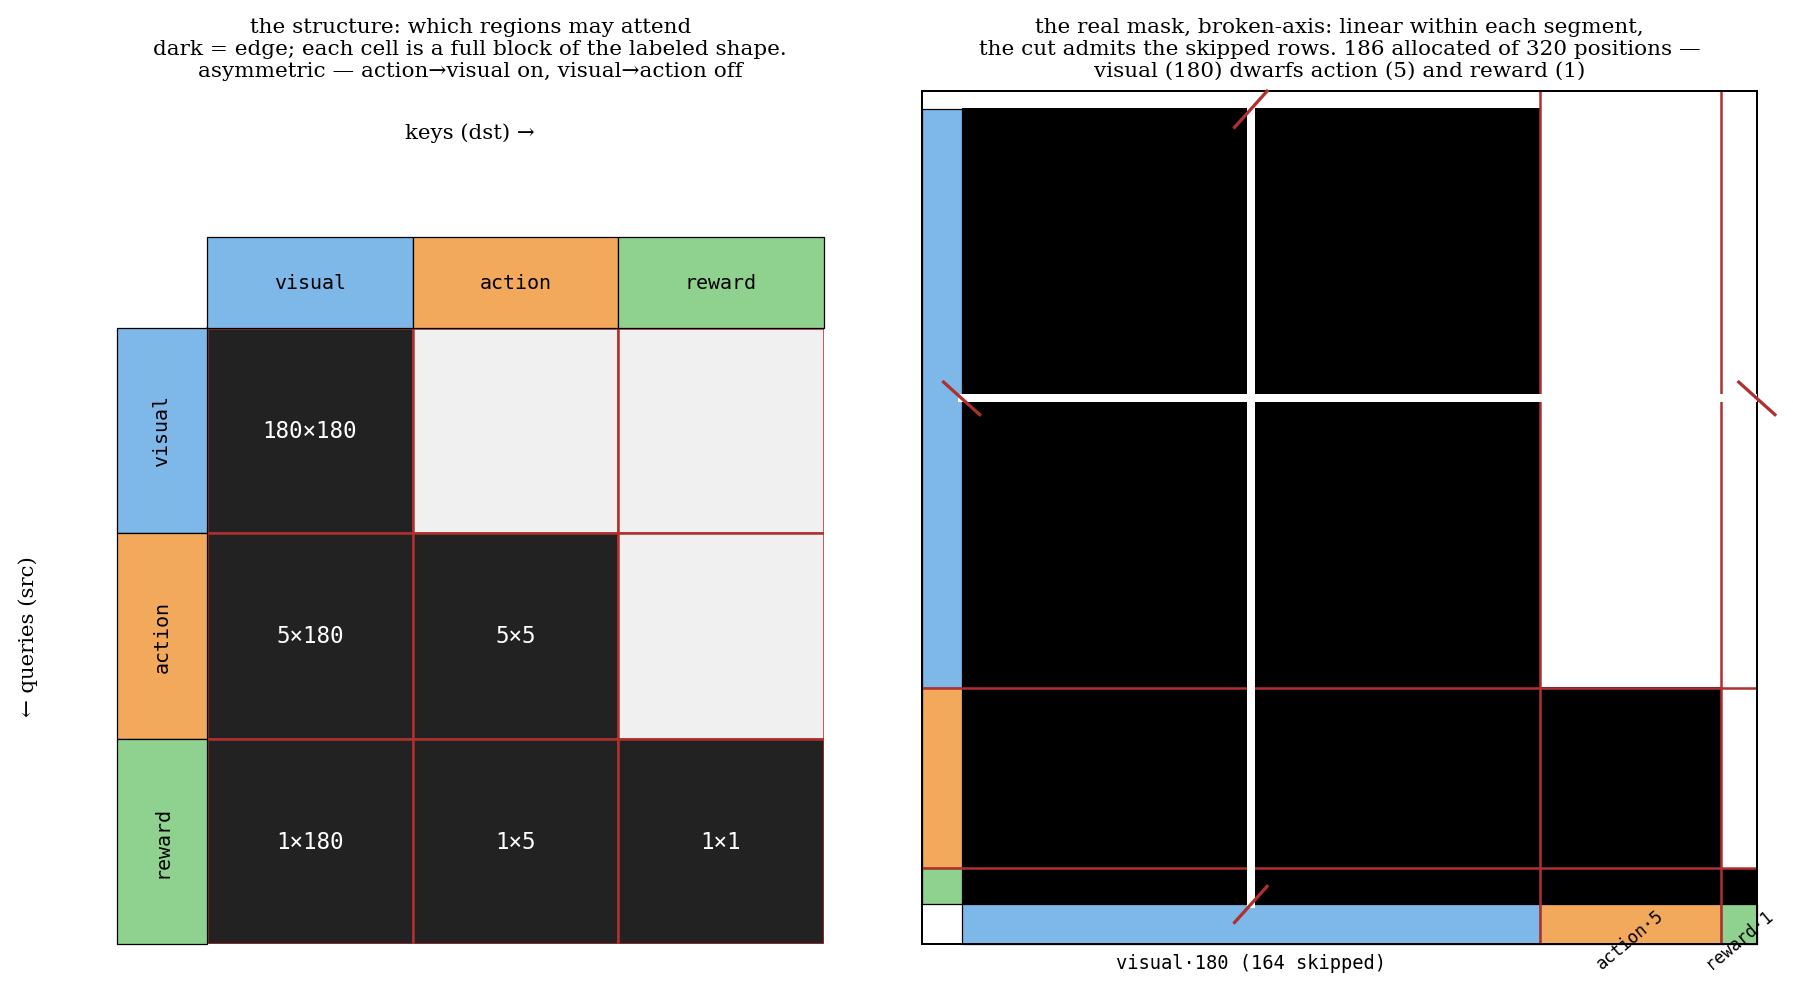
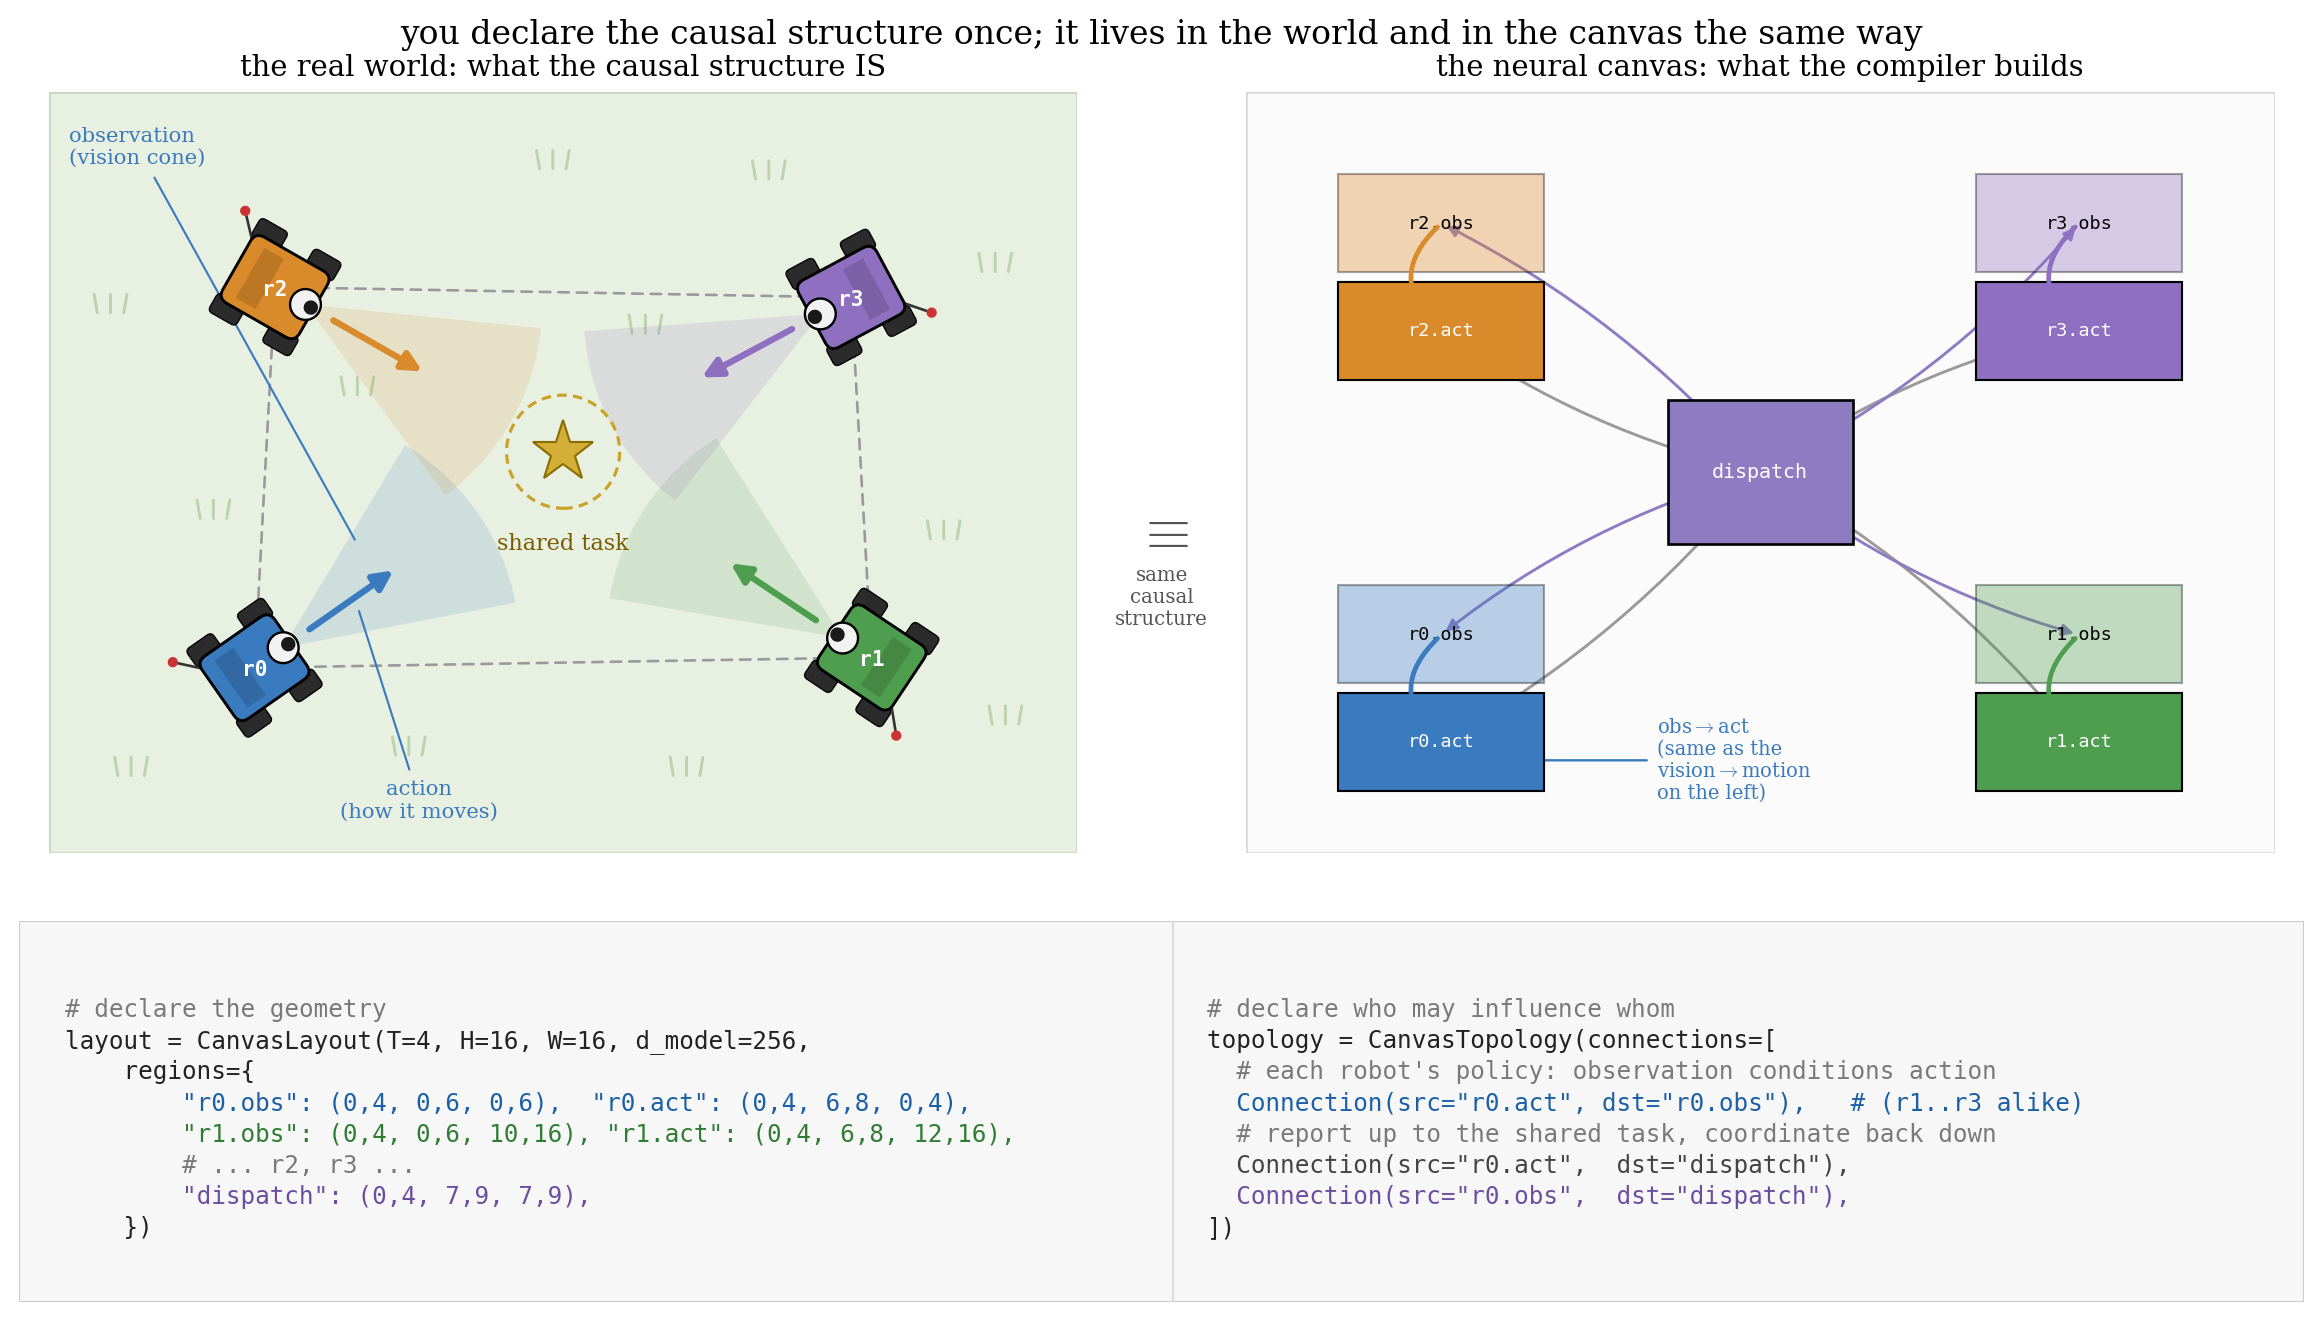
这样看,熟悉的架构都成了特例。标准的马尔可夫扩散策略不过是一张两节点画布:(观测) → 动作,以及(观测 + 动作) → 下一步观测。多智能体协同的零件更多,却同样干净——每个智能体在自己的观测与动作上自注意,智能体之间只通过你声明的跨区域边协同。拓扑就是协同协议,以数据的形式写出来。
用代码声明:schema 编译成画布
手工分配潜空间地盘并不可扩展。所以还有更高的一层:canvas engineering 库是一个面向类型化 schema 声明的编译器。你把因果结构写成一个普通的 Python 对象——带字段、损失权重与更新时钟的嵌套类型化 dataclass——然后由 compile_schema() 替你摊平成区域与注意力掩码。复杂关系被显式、透明地声明出来,写在你可以逐行审阅的代码里。
为了给它加压,我们描述了一间医院 ICU 病区的大尺度结构:六名有器官级生理指标的病人、四名带疲劳动力学的护士、保险与人力压力,以及家庭单元。一次 compile_schema() 调用就在画布上分配并打包了 199 个区域与 1077 条连接——heart_rate 每帧更新,creatinine 每 24 帧更新,各自按声明的时钟走。
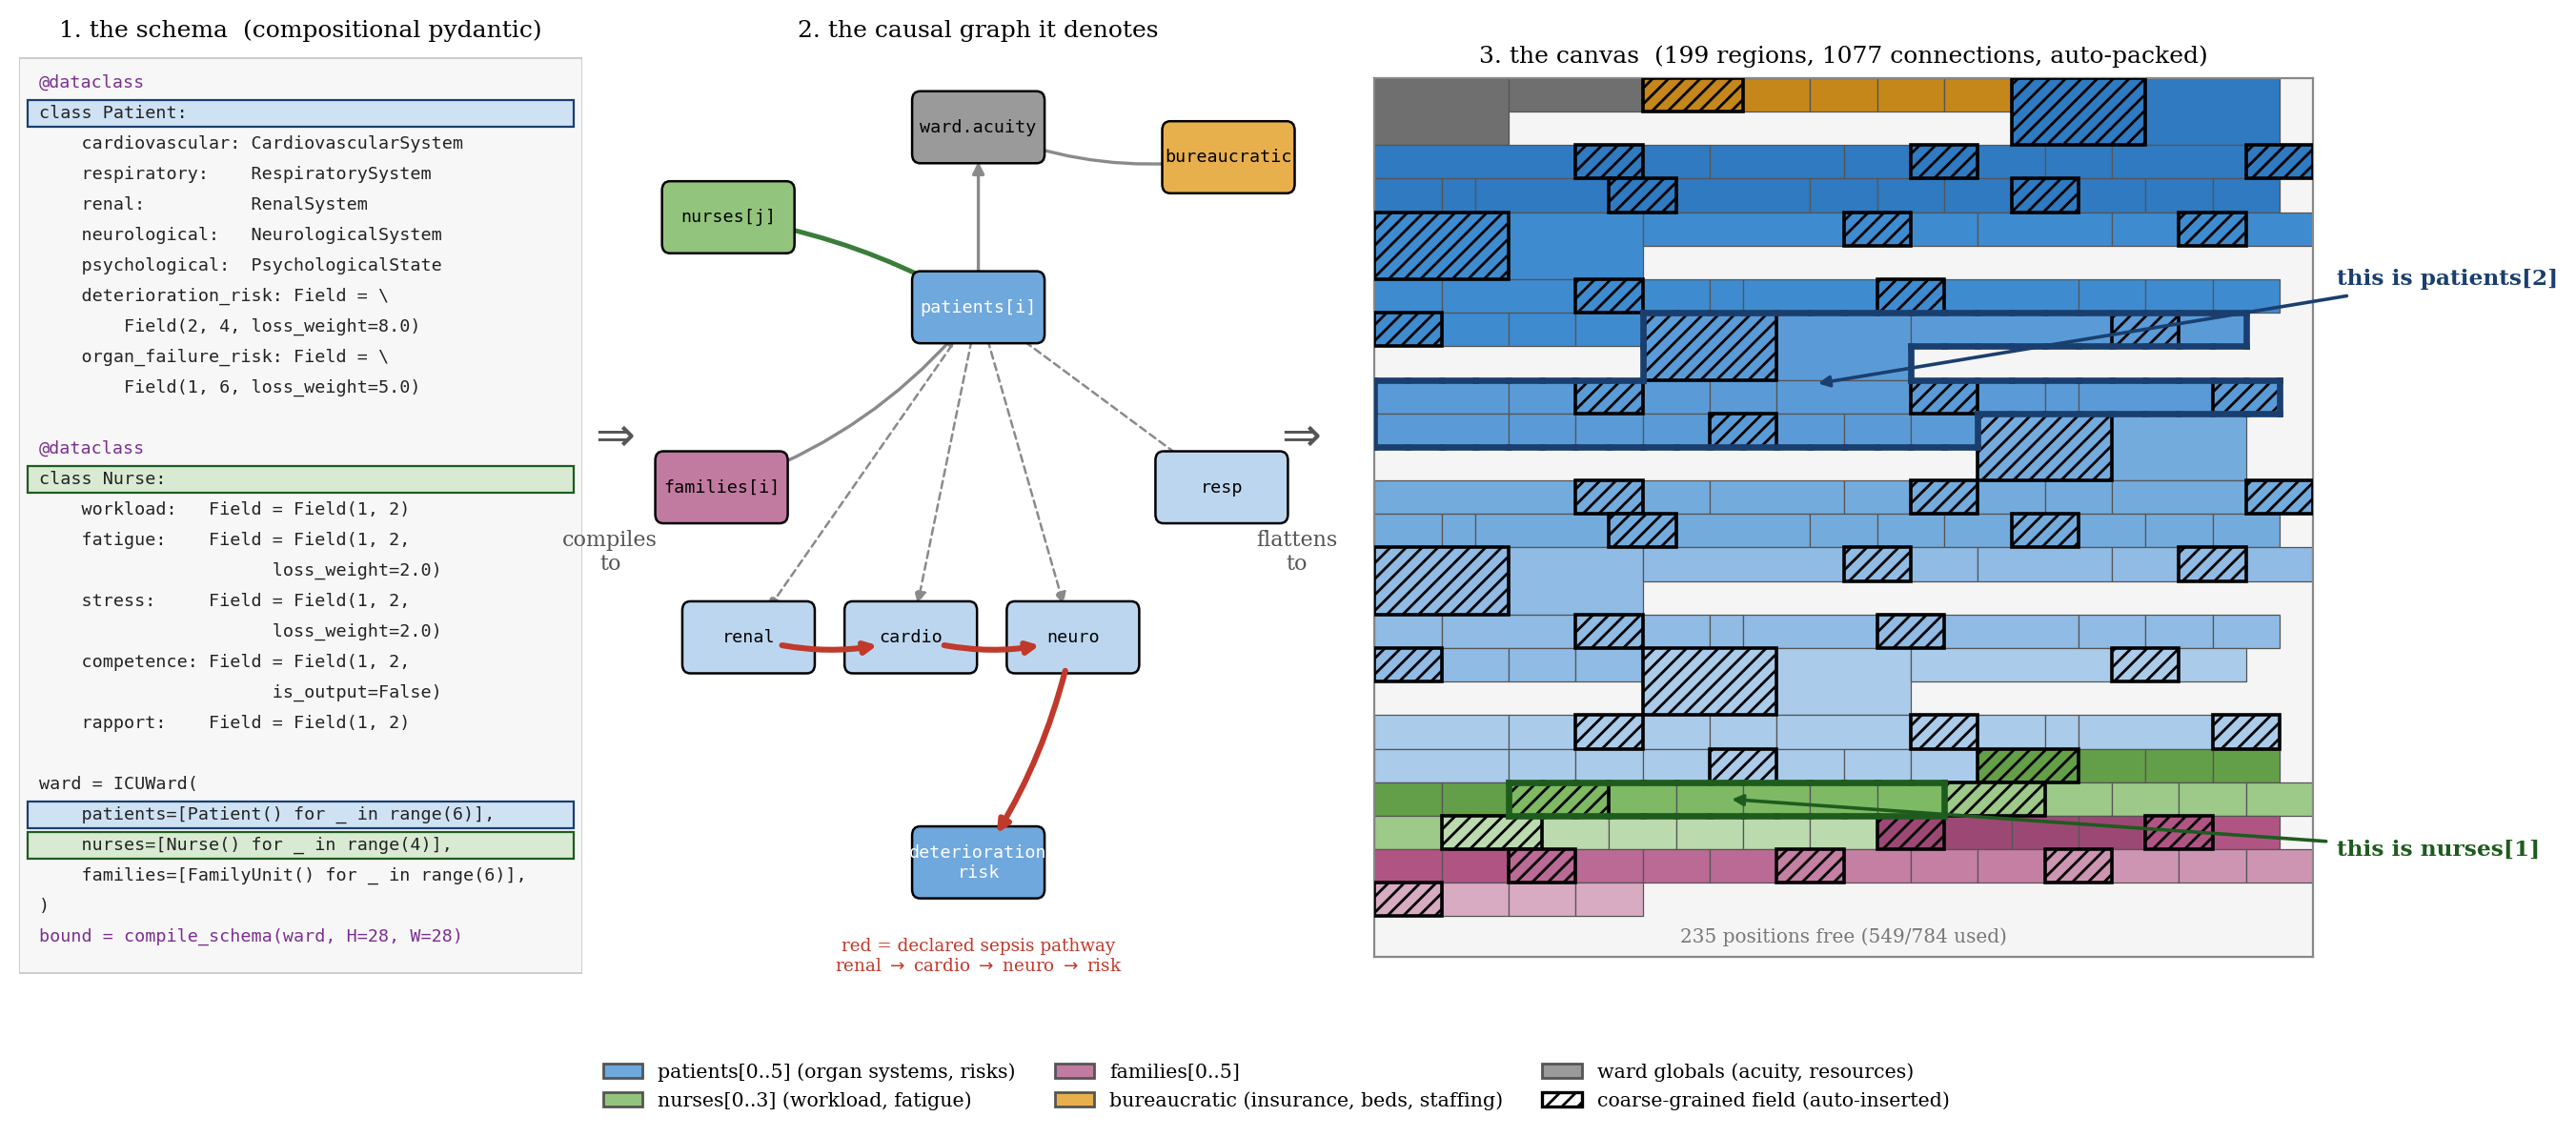
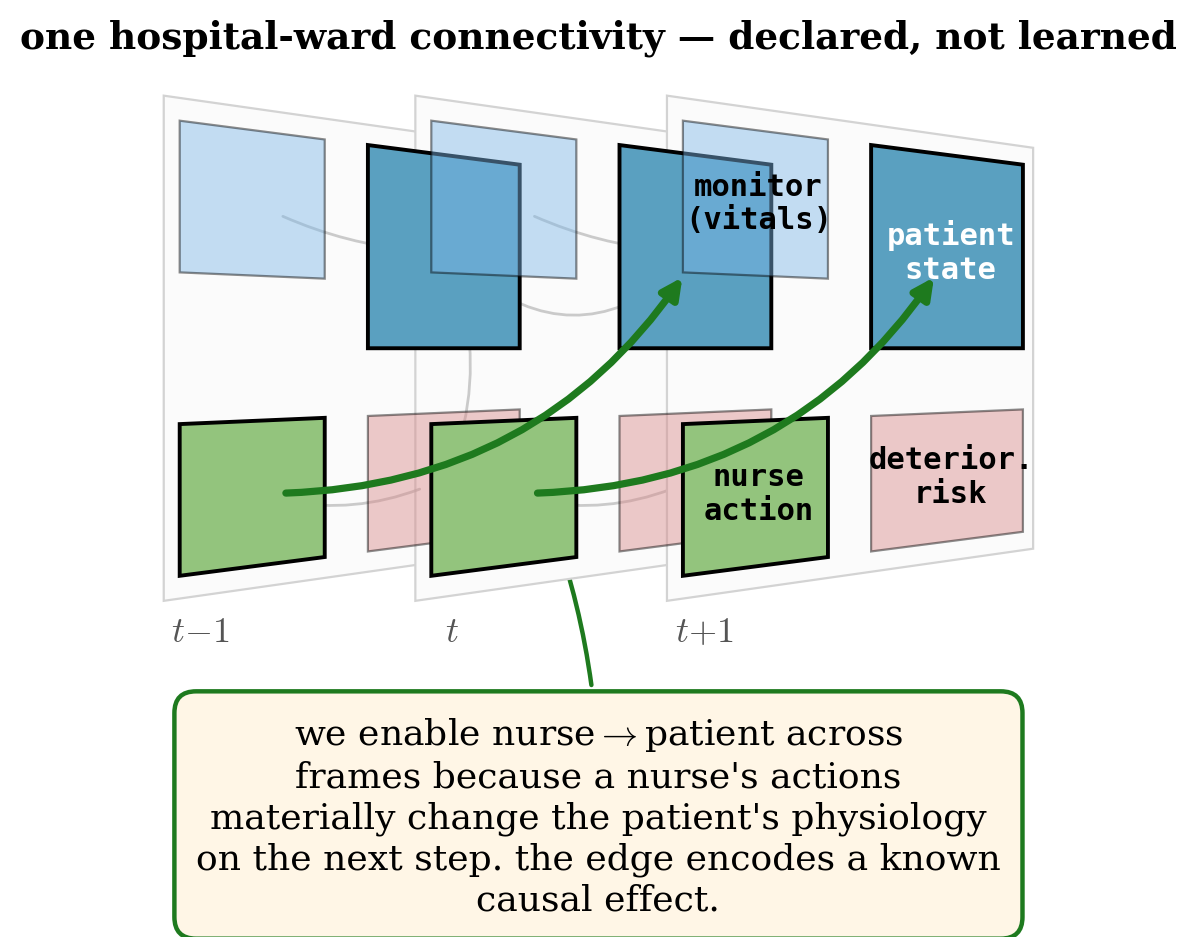
关键在于,每个区域、每条边都是一个你可以回读的决定。下面是同一份声明的病区连通性的三种视图,各自高亮一条不同的连边——护士的动作跨帧改变病人、状态喂给风险、状态随时间延续——并各自标注了它存在的因果理由。你不必再靠探针去反推模型碰巧学到了什么;图是你写的。
潜张量是可寻址的
这份可读性指向一个更深的性质。画布 schema 与 C 语言 struct 的语义是对应的:区域边界是结构体偏移,拓扑是调用约定,序列化后的 schema 就是一份 ABI。潜张量因此变得可寻址——你能准确指出哪些位置是 nurses[1] 并把它们读出来。这是给编译器用的内存映射,只不过发生在潜空间扩散画布上。
于是共享同一份 schema 的两个模型可以直接交换潜状态——不用分词,也不用重新编码。当扩散只是 GPU 上的一段 torch 时,这没什么可激动的;但当你必须把为生成猫咪视频而优化的硅片改造去干正经活时,它就要紧了:共享 ABI 正是你在芯片之间搬运潜状态、而中间不插一次解码/编码往返的方式。
测量结果究竟说明了什么
实证记录是刻意诚实的。在 CogVideoX-2B 上基于 BridgeData V2 的 26 组实验、236 次训练中,最醒目的是一项关于循环注意力的研究——用习得的迭代嵌入反复迭代冻结的扩散 Transformer 块。一个仅有 35 万可训练参数的冻结三循环配置,胜过了所有 1170 万参数的非冻结配置——参数效率 1.73×,p < 0.001,且循环表示收敛到不动点。
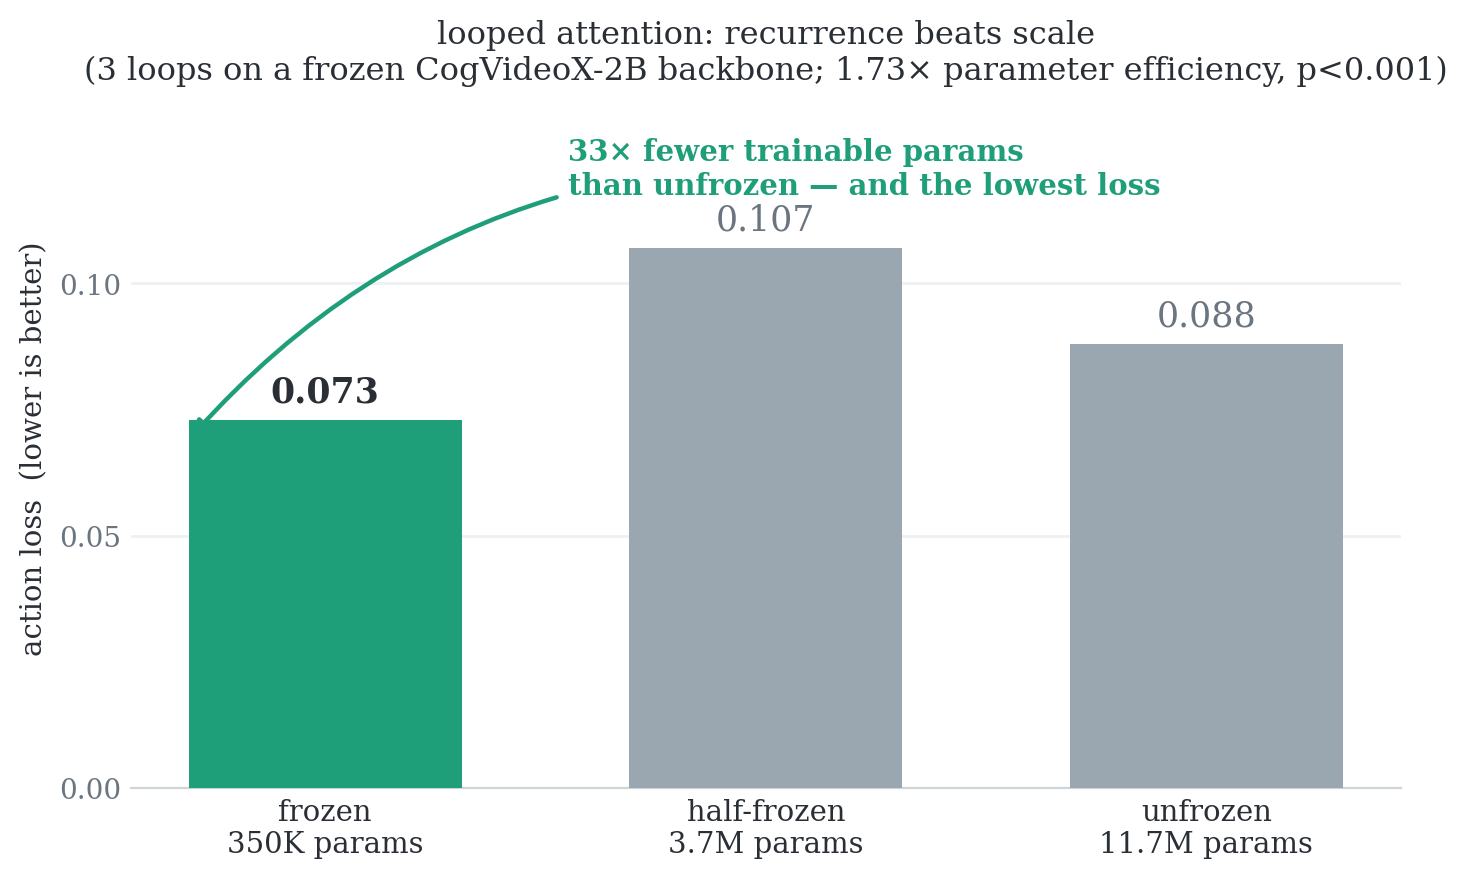
有三条校准让这个故事保持诚实:
- 在这个规模上,循环带来的好处是权重共享式的正则化,而不是可检测的迭代推理。我们照实说。
- 结构必须被声明:让各模态扁平地共处一处,会让联合预测退化 19%(p < 0.0001)。把 token 塞进同一个张量并不是结构,拓扑才是。
- 画布设计是宽容的——损失对 token 究竟怎么分配几乎不敏感(α = 0.011)。你要做对的是图,而不是像素预算。
有两条边界我们始终守住:ICU 与空管的设计是架构演示,而非经过验证的临床或运行系统;皮层模型预测的是一个脑编码器的输出,而不是直接测得的神经活动。
还有哪些悬而未决
关键一环是表示稳定性:schema 中介的潜状态交换、迁移距离标定、即插即用的模态,全都假定相同的声明结构会在不同随机种子与不同骨干上诱导出可预期地对齐的几何。这看似合理,但尚未证明。再往后:一次决定性的消融,比较声明拓扑与扁平拓扑在绑定问题上的差别;当数据与参数规模越过 2B 之后,声明结构是否还继续兑现;以及习得拓扑——在稀疏先验下提议并剪除边,把声明的 schema 当作先验而非定论。
上手试试
Canvas Engineering 把符号产物变成一份 schema——一套面向潜空间计算的类型系统——其执行就是现成扩散 Transformer 内部的掩码注意力,从而消解了神经与符号的边界。论文里有完整推导、若干做透的设计(操作、车队、空管、ICU、皮层),以及全部实验档案。
代码库
一个 Apache-2.0 编译器,把由区域、连通性与更新时钟组成的类型化 schema,下译为现成预训练扩散 Transformer 上的注意力掩码。附带可直接运行的示例:cartpole、车队、医院模型与脑连接。
pip install canvas-engineeringfrom canvas_engineering import compile_schema, CanvasModel
# Declare the causal macrostructure; the compiler lays it out.
canvas = compile_schema(MySchema) # regions + attention mask
model = CanvasModel.from_pretrained("cogvideox-2b", canvas=canvas)
model.fit(dataset) # gradients learn the weights
state = model.rollout(obs) # you fixed the wiring